Vous demandez à une IA de vous aider à présenter votre boutique. Un court silence, puis les premières phrases apparaissent. Sur le téléphone, l’opération tient dans une fenêtre de conversation. Ailleurs, des machines viennent de recevoir votre texte, de le transformer en nombres et d’effectuer les calculs nécessaires pour produire la réponse.
Ces machines ont une adresse. Elles occupent des bâtiments, dépendent d’une alimentation électrique et dégagent de la chaleur qu’il faut évacuer. Pour comprendre comment fonctionne un data center consacré à l’IA, suivons cette demande jusqu’aux serveurs.
Le cloud commence dans un bâtiment
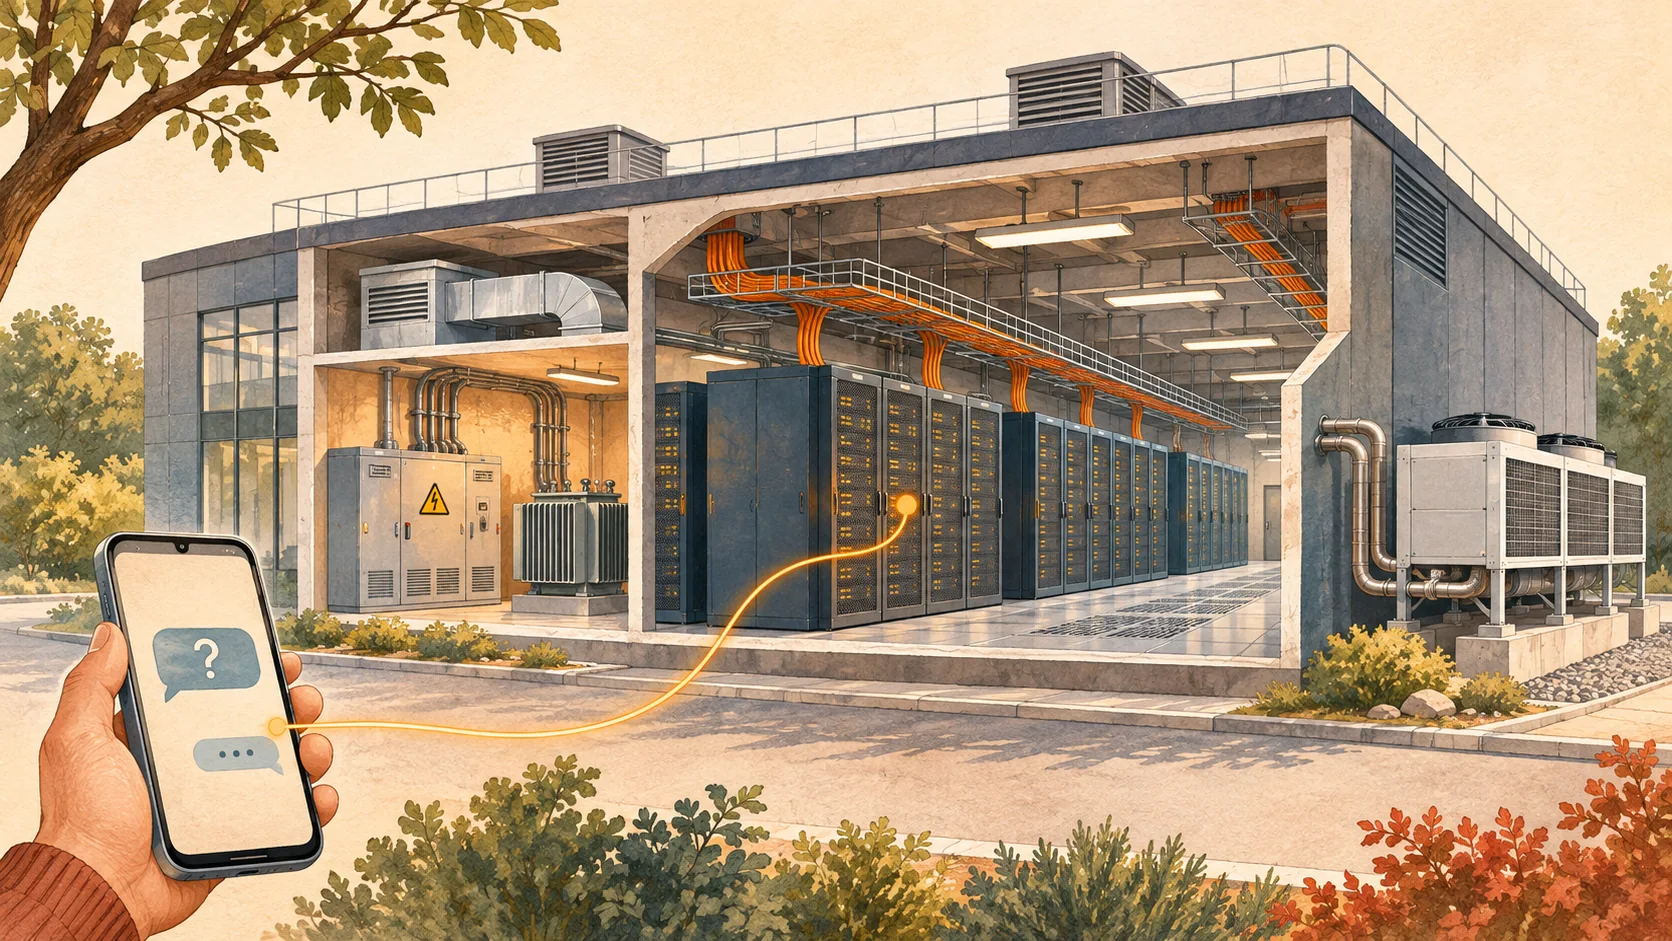
Un data center, ou centre de données, est un lieu aménagé pour faire fonctionner des équipements informatiques. Des serveurs y exécutent les applications. D’autres équipements stockent les fichiers, relient les machines entre elles et assurent leur connexion au reste du réseau.
À ces ordinateurs s’ajoutent les installations qui permettent de les utiliser jour et nuit. L’électricité doit arriver de manière fiable. Des batteries et, selon le site, des groupes électrogènes prennent le relais lors d’une coupure. Le refroidissement maintient les équipements dans leurs conditions de fonctionnement. L’accès physique aux salles est contrôlé.
Votre messagerie, un site WordPress et un assistant IA peuvent tous dépendre de centres de données. Ils n’y demandent pourtant pas les mêmes ressources. Un service qui génère du texte avec un grand modèle de langage peut nécessiter des accélérateurs spécialisés et des échanges très rapides entre machines. C’est ce qui explique une partie des différences entre un centre informatique classique et une installation destinée aux charges d’IA. IBM décrit ces composants et leurs rôles.
Le mot « cloud » décrit la manière d’accéder à ces ressources à distance. Le matériel, lui, reste bien quelque part.
Votre question arrive avec un peu de contexte
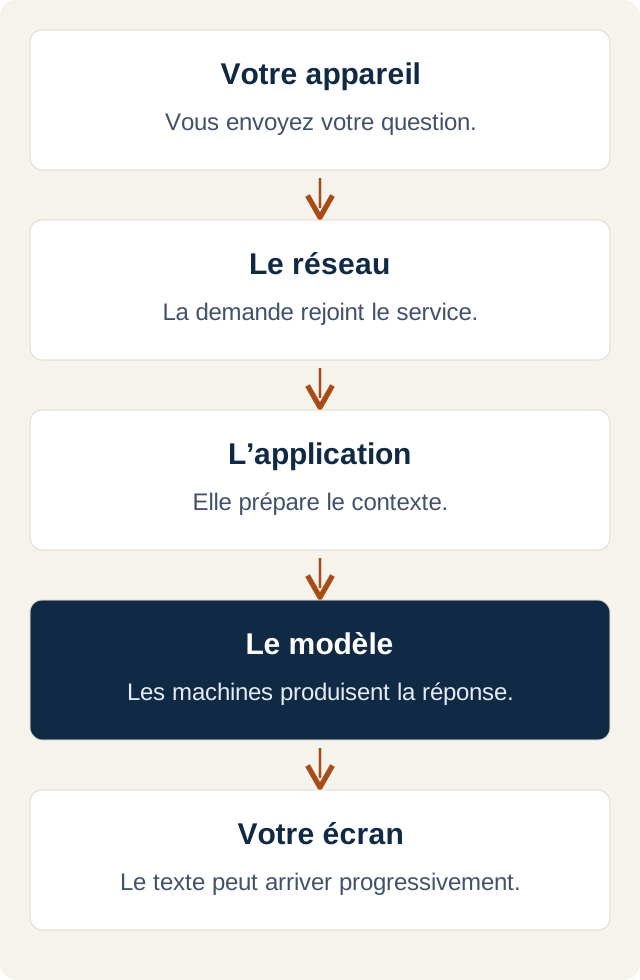
Quand vous envoyez votre message, il passe par votre connexion Internet puis par plusieurs équipements réseau. Le service le reçoit dans son infrastructure. Le trajet exact dépend de votre position, de son organisation et de la charge du moment. Votre requête n’arrive donc pas forcément dans le bâtiment le plus proche.
Avant de solliciter le modèle, l’application peut vérifier votre accès, appliquer ses limites d’utilisation et préparer les informations nécessaires. Votre nouvelle question peut être accompagnée d’une partie de la conversation, d’instructions définies par le service ou de documents que vous avez ajoutés. Les détails varient d’un produit à l’autre.
Cette distinction devient utile lorsqu’on construit son propre assistant. Le site que le visiteur ouvre et le modèle qui lui répond peuvent tourner chez deux prestataires différents. Le premier reçoit la demande, appelle le second par une API, puis affiche son résultat. Une API est simplement l’interface qui permet à ces logiciels d’échanger.
Pour le modèle, le texte devient des nombres
Un modèle de langage ne manipule pas directement les lettres telles que vous les voyez. Un outil appelé tokenizer découpe le texte en unités, les tokens, puis les associe à des identifiants numériques. Un token peut correspondre à un mot, à un morceau de mot ou à un signe de ponctuation. Le découpage dépend du modèle et de la langue.
Il n’existe donc pas de conversion fixe entre une page de français, une page d’arabe et un nombre de tokens. C’est aussi pour cela qu’un fournisseur peut facturer selon la quantité de texte traitée et générée, plutôt que selon le nombre de questions posées. Les détails du découpage sont expliqués dans la documentation des tokenizers de Hugging Face.
Le modèle utilise ensuite ces identifiants pour retrouver des représentations numériques. Ses couches de calcul les transforment en tenant compte du contexte. Dans un modèle génératif de texte, ce travail sert notamment à déterminer les tokens qui pourraient suivre, puis à en sélectionner un selon les réglages de génération.
Cela ne consiste pas à ouvrir un fichier où votre réponse attendait déjà. Le système peut néanmoins chercher des informations dans des documents ou sur le Web avant de rédiger. La recherche et la génération peuvent ainsi travailler ensemble. Leur association ne dispense pas de vérifier une affirmation ou une source.
Le modèle a appris avant votre arrivée
Pour qu’un modèle puisse produire ces réponses, il faut d’abord l’entraîner. Pendant cette étape, ses paramètres sont ajustés à partir de données et d’objectifs d’apprentissage. Ces paramètres sont les valeurs numériques qui déterminent une grande partie de son comportement.
L’entraînement des plus grands modèles mobilise des ensembles de machines pendant une longue période. Mais ce n’est pas cette opération complète qui recommence à chaque question. Lorsque vous utilisez le modèle déjà préparé, vous êtes dans la phase appelée inférence. Le service charge ou conserve le modèle en mémoire et l’utilise pour traiter les demandes.
Votre conversation peut influencer la réponse parce qu’elle fait partie du contexte transmis. Cela ne signifie pas que le modèle réécrit immédiatement ses paramètres pour apprendre durablement votre discussion. La conservation des conversations et leur éventuelle utilisation pour de futurs entraînements sont encore d’autres questions, liées au fonctionnement et aux conditions du service. Le parcours décrit par Intel aide à distinguer entraînement et mise en service.
Un modèle relativement petit peut fonctionner sur un ordinateur personnel. À l’autre extrême, certains systèmes sont répartis sur plusieurs accélérateurs. Il faut connaître le modèle et la tâche avant de parler du matériel nécessaire.
Pourquoi la réponse apparaît progressivement
La génération de texte comporte souvent deux moments distincts. Le premier traite le texte fourni en entrée. On parle de prefill. Le second produit la suite de la réponse, généralement token après token. On parle de décodage.
Une partie des résultats intermédiaires peut être gardée dans une mémoire de travail appelée cache KV. Le modèle s’en sert pour éviter de recalculer certaines informations sur les tokens déjà traités. Ce cache accélère la génération, mais occupe de la mémoire. Il ne faut pas le confondre avec un historique enregistré dans votre compte ou avec des souvenirs conservés entre deux conversations. Hugging Face explique ce mécanisme de cache.
L’application peut transmettre les morceaux de réponse à mesure qu’ils deviennent disponibles. C’est le streaming. L’affichage donne parfois l’impression que l’IA écrit lettre par lettre, alors que les fragments reçus ne correspondent pas nécessairement à des lettres ou à des mots entiers.
Le silence avant la première phrase ne permet pas, à lui seul, de savoir ce que fait le service. Il peut comprendre l’attente d’une machine disponible, le traitement du contexte, des étapes de raisonnement, l’appel d’un outil ou simplement du délai réseau. Cette explication du prefill et du décodage par TNG montre pourquoi le temps avant le premier token et la vitesse de la suite sont deux mesures différentes.
Des processeurs rapides ont besoin de données à temps
Dans un serveur d’IA, le CPU continue de faire fonctionner le système et de coordonner de nombreuses opérations. Les GPU et d’autres accélérateurs prennent en charge les calculs pour lesquels leur architecture est adaptée. Un GPU peut effectuer de nombreuses opérations similaires en parallèle, ce qui convient notamment aux calculs matriciels des réseaux de neurones.
La puissance de calcul ne suffit pourtant pas. Les valeurs utilisées par le modèle doivent arriver assez vite depuis la mémoire. Pour certaines phases de génération, les unités de calcul pourraient travailler davantage, mais attendent les données dont elles ont besoin. Augmenter uniquement leur puissance ne résout pas ce problème.
La mémoire HBM, employée sur certains accélérateurs, permet des échanges très rapides à proximité de la puce. Les SSD servent notamment à conserver les fichiers et les modèles avant leur chargement. Ils ne remplacent pas la mémoire rapide utilisée pendant le calcul. De la place libre sur un disque ne signifie donc pas qu’un serveur peut exécuter n’importe quel modèle.
Lorsque le travail est réparti entre plusieurs accélérateurs, le réseau entre eux compte aussi. Ils doivent échanger des données et coordonner leurs opérations. Une communication lente peut retarder l’ensemble. À titre d’exemple, le GB200 NVL72 de NVIDIA réunit 72 GPU et 36 CPU dans une architecture refroidie par liquide, avec des interconnexions spécialisées. Ce système illustre une installation de grande capacité, pas une configuration nécessaire à toute application d’IA.
L’électricité finit surtout en chaleur
Les équipements électriques dissipent de la chaleur pendant leur fonctionnement. Plus on concentre de matériel puissant dans une baie, plus il faut évacuer de chaleur dans un espace réduit. Une salle de serveurs doit être conçue pour cette contrainte dès le départ.
Selon la densité des équipements, le refroidissement utilise de l’air, des circuits liquides ou une combinaison des deux. Avec le refroidissement direct des puces, un liquide circule dans des plaques qui récupèrent la chaleur au contact des composants. Elle est ensuite transportée vers le reste du système de refroidissement du bâtiment.
La consommation d’eau dépend de la manière dont ce système rejette finalement la chaleur, mais aussi du climat et de son exploitation. La présence d’un circuit liquide près des puces ne donne pas, à elle seule, la quantité d’eau consommée par le site. Les recommandations de conception des centres de données de NVIDIA montrent l’importance de traiter ensemble l’alimentation et le refroidissement.
Les contraintes ne s’arrêtent pas aux murs du bâtiment. Un projet doit obtenir suffisamment de puissance électrique et les équipements nécessaires à son raccordement. Acheter les serveurs ne suffit pas pour pouvoir les allumer.
Une réponse courte et une vidéo ne coûtent pas la même chose
L’Agence internationale de l’énergie estime que les centres de données ont utilisé environ 485 térawattheures d’électricité dans le monde en 2025. Son scénario actualisé prévoit environ 950 TWh en 2030. Il s’agit de l’ensemble des centres de données, pas seulement des conversations avec des IA, et le chiffre pour 2030 reste une projection.
Le rapport 2026 de l’AIE souligne aussi une différence importante entre les usages. Une courte génération de texte, une vidéo et une tâche exécutée par un agent ne demandent pas la même quantité de calcul. Un coût universel « par question » masquerait ces écarts, ainsi que les différences entre modèles, machines et longueurs de réponse.
Les logiciels changent également la facture. Plusieurs demandes peuvent être traitées ensemble pour mieux utiliser les équipements. Certains calculs sont réutilisés. D’autres optimisations réduisent la mémoire nécessaire, parfois au prix de compromis sur la précision ou la qualité. C’est ce qui explique qu’un service puisse devenir moins coûteux sans attendre le remplacement de toutes ses machines.
Ce que cela change pour votre propre projet
Si vous voulez un assistant sur votre site, vous n’avez généralement pas besoin de commencer par acheter des GPU. Votre application peut utiliser un modèle fourni par API. Votre hébergement fait alors fonctionner le site et sa logique, tandis que le fournisseur du modèle prend en charge la génération. Il faut toujours prévoir le coût de cette API et examiner les données que vous lui envoyez.
Si vous souhaitez exécuter le modèle vous-même, le choix devient différent. Il faut vérifier sa licence, sa taille, ses besoins en mémoire, la vitesse attendue et le nombre d’utilisateurs simultanés. Un VPS adapté à une application web n’est pas automatiquement dimensionné pour un grand modèle de langage.
Cette distinction aide aussi à situer nos outils. Créer un site avec Sahara AI, déployer une application depuis GitHub et héberger des automatisations avec n8n répondent à des besoins différents. Aucun de ces usages ne signifie qu’un cluster de GPU est inclus dans votre hébergement.
Vous pouvez donc commencer par le service que vous voulez rendre. Un catalogue, un assistant de support ou une automatisation n’appellent pas forcément la même architecture. Le bon choix dépendra du travail à accomplir, de vos données et du niveau de contrôle dont vous avez besoin.