تطلب من مساعد ذكاء اصطناعي أن يساعدك في تقديم متجرك. تمر لحظة قصيرة، ثم تبدأ الجمل بالظهور على الهاتف. ما تراه أمامك نافذة محادثة، لكن في مكان آخر استقبلت أجهزة حاسوب نصك وحولته إلى أرقام وأجرت العمليات اللازمة لإنتاج الإجابة.
لهذه الأجهزة مكان فعلي. تعمل داخل مبانٍ تحتاج إلى الكهرباء وإلى تجهيزات تنقل الحرارة بعيدًا عن مكوناتها. لفهم كيف يعمل مركز البيانات الذي يشغّل الذكاء الاصطناعي، سنتابع طلبك من لحظة إرساله حتى وصوله إلى الخوادم.
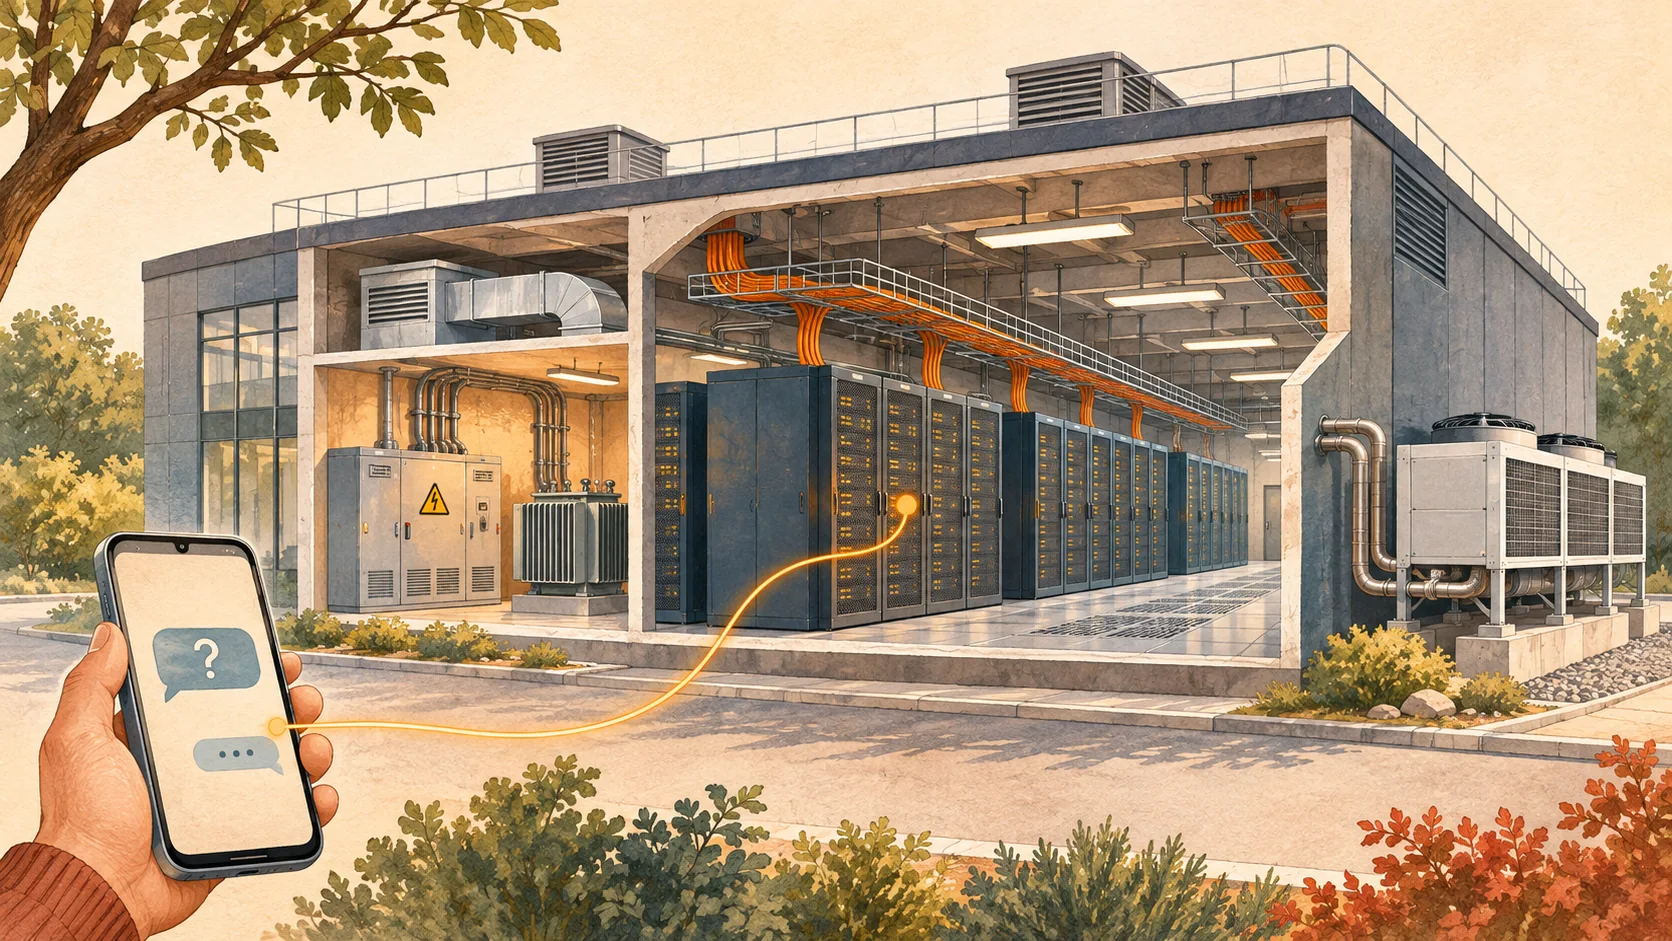
السحابة تبدأ داخل مبنى
مركز البيانات، أو Data Center، هو مكان مجهّز لتشغيل الأنظمة المعلوماتية. تنفّذ الخوادم التطبيقات، وتحفظ تجهيزات أخرى الملفات، بينما تربط معدات الشبكة الأجهزة ببعضها وبالعالم الخارجي.
إلى جانب الحواسيب توجد البنية التي تسمح باستمرار العمل. يحتاج الموقع إلى تغذية كهربائية موثوقة، وبطاريات تتدخل عند الانقطاع، وقد يضم مولدات احتياطية. تحافظ أنظمة التبريد على ظروف التشغيل المناسبة، وتُنظَّم صلاحيات الدخول إلى القاعات.
يمكن لبريدك الإلكتروني وموقع WordPress ومساعد ذكاء اصطناعي أن تعتمد جميعها على مراكز بيانات. لكن مواردها المطلوبة تختلف. توليد النصوص بنموذج لغوي كبير قد يستدعي مسرّعات متخصصة واتصالات سريعة بين الأجهزة. وهذا يفسر جانبًا من الفرق بين مركز تقليدي ومنشأة مهيأة لأحمال الذكاء الاصطناعي. تشرح IBM مكونات مراكز بيانات الذكاء الاصطناعي وأدوارها.
كلمة «السحابة» تصف الوصول إلى الموارد عن بُعد. أما الأجهزة نفسها فتبقى موجودة في مكان محدد.
يصل سؤالك ومعه سياقه
بعد الإرسال، يمر نصك عبر اتصال الإنترنت وعدة معدات شبكية قبل أن يستقبله مزوّد الخدمة. يتحدد المسار حسب موقعك وتنظيم شبكة المزوّد والضغط على الخدمة. لذلك لا يصل الطلب بالضرورة إلى أقرب مبنى جغرافيًا.
قبل استدعاء النموذج، قد يتحقق التطبيق من حسابك وحدود الاستخدام ويجهّز المعلومات المطلوبة. يمكن أن يرافق السؤال جزء من المحادثة السابقة وتعليمات الخدمة ووثائق أضفتها. تختلف التفاصيل من منتج إلى آخر.
هذه النقطة مهمة إذا أردت بناء مساعد لموقعك. قد يعمل الموقع عند مزوّد استضافة، بينما يعمل النموذج عند مزوّد آخر. يستقبل الموقع الطلب، ويرسله إلى النموذج عبر API، ثم يعرض النتيجة. والـ API هي الواجهة التي تسمح للبرامج بالتواصل فيما بينها.
يتحول النص إلى أرقام
لا يعالج النموذج الحروف كما تظهر على الشاشة مباشرة. تقسم أداة تسمى tokenizer النص إلى وحدات تسمى tokens، أو رموز نصية، وتربط كل وحدة بمعرّف رقمي. قد يكون الرمز كلمة كاملة أو جزءًا منها أو علامة ترقيم. يتغير التقسيم حسب النموذج واللغة.
لهذا لا توجد قاعدة ثابتة تحوّل صفحة عربية وصفحة فرنسية إلى العدد نفسه من الرموز. وقد تعتمد فاتورة المزوّد على كمية النص الذي عالجه وولّده بدل الاكتفاء بعدّ الأسئلة. توضح وثائق Hugging Face الخاصة بتقسيم النصوص كيف تعمل هذه الأدوات.
يستخرج النموذج تمثيلات رقمية من هذه المعرّفات، ثم تمر عبر طبقات الحساب مع مراعاة السياق. وفي توليد النص، تُستخدم النتائج لتقدير الرموز التي يمكن أن تأتي بعد النص الحالي، ثم اختيار أحدها وفق إعدادات التوليد.
لا يفتح النظام ببساطة ملفًا يحتوي إجابتك جاهزة. لكنه قد يبحث في وثائق أو على الويب قبل صياغتها. يمكن الجمع بين البحث والتوليد، ولا يعفي ذلك من التحقق من الادعاءات والمصادر.
تعلّم النموذج قبل أن تفتح المحادثة
حتى يستطيع النموذج إنتاج هذه الإجابات، يمر أولًا بالتدريب. تُضبط خلاله معلماته انطلاقًا من بيانات وأهداف تعلم. والمعلمات هي القيم الرقمية التي تحدد جانبًا كبيرًا من سلوكه.
يستدعي تدريب أكبر النماذج مجموعات من الأجهزة تعمل لفترات طويلة. لكن هذه العملية الكاملة لا تبدأ من جديد مع كل سؤال. عند استخدام النموذج المُعدّ مسبقًا، نكون في مرحلة الاستدلال، أو inference. تشغّل الخدمة النموذج لمعالجة الطلبات، بعد تحميله في الذاكرة أو إبقائه فيها.
تؤثر المحادثة في الإجابة عندما تدخل ضمن السياق الذي يتلقاه النموذج. هذا لا يعني أنه يعيد فورًا كتابة معلماته ليتعلم نقاشك بصورة دائمة. أما حفظ المحادثات واستخدامها المحتمل في تدريب لاحق فهما مسألتان أخريان ترتبطان بسياسة الخدمة وتشغيلها. يساعد شرح Intel لمراحل العمل على التمييز بين التدريب والاستخدام.
قد يعمل نموذج صغير نسبيًا على حاسوب شخصي، بينما تتوزع أنظمة أخرى على عدة مسرّعات. يجب معرفة النموذج والمهمة قبل تحديد العتاد المطلوب.
لماذا تظهر الإجابة تدريجيًا
يمر توليد النص غالبًا بمرحلتين. تعالج الأولى النص المدخل وتسمى prefill. ثم تأتي مرحلة توليد ما يليه، عادة رمزًا بعد رمز، وتسمى decoding.
يمكن الاحتفاظ بجزء من النتائج الوسيطة في ذاكرة عمل تسمى KV cache. يستخدمها النموذج لتجنب إعادة بعض الحسابات المرتبطة بالرموز التي عالجها. إنها تسرّع التوليد، لكنها تستهلك ذاكرة. وهي ليست سجل المحادثات المحفوظ في حسابك ولا ذاكرة دائمة بين الجلسات. تشرح وثائق Hugging Face آلية هذا التخزين المؤقت.
يستطيع التطبيق إرسال أجزاء الإجابة كلما أصبحت متاحة. تسمى هذه الطريقة البث التدريجي، أو streaming. قد يبدو لك أن النص يُكتب حرفًا حرفًا، لكن الأجزاء التي تصل لا تطابق بالضرورة الحروف أو الكلمات الكاملة.
ولا يكشف الانتظار قبل ظهور أول جملة وحده عما يجري داخل الخدمة. قد يشمل انتظار جهاز متاح ومعالجة السياق وخطوات استدلال واستدعاء أداة وتأخر الشبكة. يوضح شرح TNG لمرحلتي prefill وdecoding الفرق بين زمن وصول أول رمز وسرعة إنتاج بقية النص.
سرعة الحساب تحتاج إلى وصول البيانات
يبقى المعالج المركزي CPU مسؤولًا عن تشغيل النظام وتنسيق عمليات كثيرة داخل خادم الذكاء الاصطناعي. أما وحدات GPU وغيرها من المسرّعات فتتولى الحسابات المناسبة لبنيتها. يستطيع GPU تنفيذ عدد كبير من العمليات المتشابهة بالتوازي، وهو ما يلائم مثلًا حسابات المصفوفات في الشبكات العصبية.
لكن القدرة الحسابية وحدها لا تكفي. يجب أن تصل القيم التي يستخدمها النموذج بسرعة من الذاكرة. في بعض مراحل التوليد، تستطيع وحدات الحساب تنفيذ عمل أكبر، لكنها تنتظر البيانات. زيادة قوتها وحدها لا تزيل هذا العائق.
تتيح ذاكرة HBM الموجودة في بعض المسرّعات نقل البيانات بسرعة عالية قرب الشريحة. أما أقراص SSD فتحتفظ، من بين أشياء أخرى، بالملفات والنماذج قبل تحميلها. ولا تحل محل الذاكرة السريعة المستخدمة أثناء الحساب. وجود مساحة فارغة على القرص لا يعني أن الخادم قادر على تشغيل أي نموذج.
وعندما تتوزع المهمة على مسرّعات متعددة، تصبح الشبكة بينها مهمة أيضًا. يجب تبادل البيانات وتنسيق العمليات، وقد يؤخر اتصال بطيء المجموعة كلها. مثال على الأنظمة الكبيرة هو GB200 NVL72 من NVIDIA، الذي يجمع 72 وحدة GPU و36 معالج CPU ضمن تصميم مبرّد بالسوائل واتصالات متخصصة. يوضح هذا المثال فئة من التجهيزات عالية القدرة، وليس متطلبًا لكل تطبيق ذكاء اصطناعي.
تتحول الكهرباء في معظمها إلى حرارة
تطلق الأجهزة الكهربائية حرارة أثناء تشغيلها. وكلما جُمعت معدات أقوى داخل خزانة واحدة، وجب نقل كمية أكبر من الحرارة من مساحة محدودة. تؤخذ هذه المسألة في الحسبان عند تصميم القاعة منذ البداية.
يُستخدم الهواء أو السوائل أو الاثنان معًا حسب كثافة التجهيزات. في التبريد المباشر للشرائح، يدور سائل داخل صفائح تسحب الحرارة من المكونات، ثم تنقلها إلى بقية منظومة تبريد المبنى.
يتوقف استهلاك الماء على طريقة طرح هذه الحرارة إلى الخارج، وعلى المناخ والتشغيل أيضًا. وجود دائرة سائلة قرب الشرائح لا يكفي لمعرفة كمية الماء المستهلكة في الموقع. تُظهر توصيات NVIDIA لتصميم مراكز البيانات أهمية دراسة الكهرباء والتبريد معًا.
وتمتد القيود إلى خارج المبنى. يحتاج المشروع إلى قدرة كهربائية كافية وإلى معدات الربط اللازمة. شراء الخوادم وحده لا يجعل تشغيلها ممكنًا.
إجابة قصيرة وفيديو لهما احتياجات مختلفة
تقدّر الوكالة الدولية للطاقة استهلاك مراكز البيانات عالميًا بنحو 485 تيراواط ساعة في 2025. ويصل تقديرها المحدّث إلى نحو 950 تيراواط ساعة في 2030. تشمل هذه الأرقام مجمل مراكز البيانات، ولا تخص المحادثات مع الذكاء الاصطناعي وحدها، كما أن رقم 2030 يبقى توقعًا.
يلفت تقرير الوكالة لسنة 2026 إلى تفاوت مهم بين الاستخدامات. إنتاج نص قصير، وتوليد فيديو، وتنفيذ مهمة عبر وكيل ذكي لا تتطلب المقدار نفسه من الحساب. إعطاء تكلفة موحدة «لكل سؤال» يخفي هذه الفروق، إلى جانب اختلاف النموذج والأجهزة وطول الإجابة.
تؤثر البرمجيات في التكلفة أيضًا. يمكن معالجة عدة طلبات معًا لتحسين استخدام المعدات، وإعادة استعمال بعض الحسابات، وتقليل الذاكرة المطلوبة بتقنيات أخرى. وقد تتطلب بعض هذه التحسينات موازنة بين الدقة والجودة والموارد. لهذا قد تنخفض تكلفة الخدمة دون انتظار تغيير جميع أجهزتها.
ماذا يعني هذا لمشروعك
إذا أردت إضافة مساعد إلى موقعك، فلا تحتاج غالبًا إلى البدء بشراء وحدات GPU. يستطيع التطبيق استخدام نموذج متاح عبر API. تشغّل استضافتك الموقع ومنطقه، بينما يتولى مزوّد النموذج توليد الإجابات. وتبقى عليك مراعاة تكلفة الواجهة والبيانات التي ترسلها إليها.
أما إذا أردت تشغيل النموذج بنفسك، فتختلف المعايير. يجب فحص ترخيصه وحجمه وذاكرته المطلوبة والسرعة المنتظرة وعدد المستخدمين المتزامنين. خادم VPS مناسب لتطبيق ويب ليس بالضرورة مناسبًا لنموذج لغوي كبير.
يساعد هذا الفرق على وضع أدواتنا في سياقها. إنشاء موقع مع Sahara AI، ونشر تطبيق من GitHub، واستضافة أتمتة n8n استخدامات مختلفة. ولا يعني أي منها أن استضافتك تتضمن مجموعة GPU.
ابدأ بالخدمة التي تريد تقديمها. قد يحتاج كتالوج ومساعد دعم وعملية أتمتة إلى ترتيبات مختلفة. ويتحدد الاختيار حسب العمل المطلوب وبياناتك ومستوى التحكم الذي تحتاج إليه.